This is an old revision of the document!
Table of Contents
ID MRZ RECOGNITION
1. Co to jest MRZ
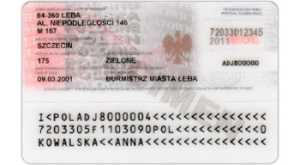
MRZ (ang. machine readable zone – strefa odczytu maszynowego) – obszar na różnego rodzaju dokumentach, zawierający zapisane czcionką do odczytu maszynowego (w przypadku dowodów osobistych jest to OCR-B) dane zawarte w danym dokumencie w sposób skrócony. Celem takiego zapisu jest ułatwienie komputerowego odczytu dokumentu na lotniskach. Dane zawarte z MRZ dowodów osobistych ułożone są w 3 liniach po 30 znaków. Używane są, podobnie jak w paszportach, litery A-Z, cyfry 0-9 oraz znak “<”.
Wiersz 1
| Pole | Znak | Znaczenie |
|---|---|---|
| 1 | A-Z | I, A lub C na oznaczenie dokumentu podróży innego niż paszport |
| 2 | A-Z | typ |
| 3-5 | A-Z | kod kraju wydającego dokument |
| 6-14 | A-Z, 0-9 | Numer dokumentu |
| 15 | 0-9 | cyfra kontrolna dla pól 6-14 |
| 16-30 | A-Z, 0-9 | inne dane, zgodnie z uznaniem państwa wydającego |
Wiersz 2
| Pole | Znak | Znaczenie |
|---|---|---|
| 1-6 | 0-9 | Data urodzenia (RRMMDD) |
| 7 | 0-9 | cyfra kontrolna dla pól 1-6 |
| 8 | A-Z | płeć (M dla mężczyzn, F dla kobiet, < dla płci nieokreślonej) |
| 9-14 | 0-9 | data ważności dokumentu (RRMMDD) |
| 15 | 0-9 | cyfra kontrolna dla pól 9-14 |
| 16-18 | A-Z | obywatelstwo |
| 19-29 | A-Z, 0-9 | inne (dla posiadaczy dokumentów amerykańskich może to być umieszczony numer ich paszportu) |
| 30 | 0-9 | cyfra kontrolna dla pól 6-30 z 1. wiersza oraz 1-7, 9-15, 19-29 z 2. wiersza |
Wiersz 3 Tu umieszczone są nazwisko (nazwiska) i imiona posiadacza w formacie NAZWISKO«IMIE«. W przypadku, gdy nazwisko jest dwuczłonowe, oba człony rozdziela znak “<”, a gdy ma się 2 imiona to również są one rozdzielone znakiem “<”. Dla osoby, która nazywa się Adam Jerzy Bachleda-Curuś, zapis będzie wyglądał BACHLEDA<CURUS«ADAM<JERZY«<. Narodowe znaki diakrytyczne są transliterowane na odpowiednie znaki alfabetu łacińskiego. Transliteracja znaków cyrylicy zależy od państwa.
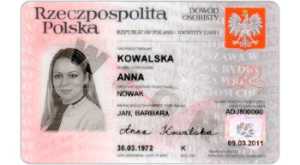
| Przykładowy dowód osobisty | |
|---|---|
 |  |
2. Realizacja, opis program
Program do odczytu strefy MRZ został napisyany w języku PYTHON (ver 2.7) z użyciem biblioteki** OpenCV. Jako klasyfikator w naszej sieci użyliśmy algorytmu **KNN (Metoda K Najbliższych Sąsiadów (k-Nearest Neighbors)- (algorytm ten jest zaimplementowany w biliotece OpenCV)
Po uruchomieniu program wyświetli nam listę zadań które można wykonać:
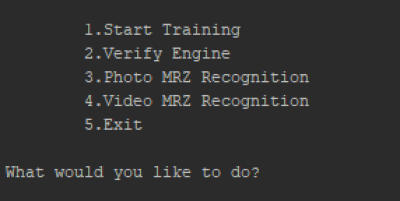
2.1 Start Training
Uczenie Nadzorowane - jest to funkcja, której zadaniem jest wygenerowanie niezbędnych plików dla klasyfikatora KNN (pliki z tablicą binarną znaku „generalresponses.data”, tablica znaków: „generalsamples.data”.)
Algorytm działania:
| Step | Description |
|---|---|
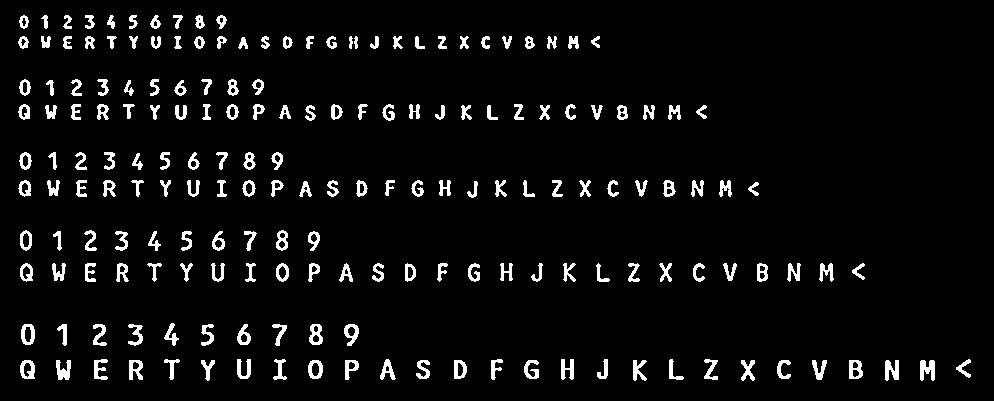
| 1 | Wyświetl przygotowany przez użytkownika plik z danymi wzorcowymi (w naszym przypadku będzie to zbiór znaków zapisanych przy użyciu trzcionki ** OCR-B**. W pliku każdy znak jest zapisany kilka razy w rożnych rozmiarach.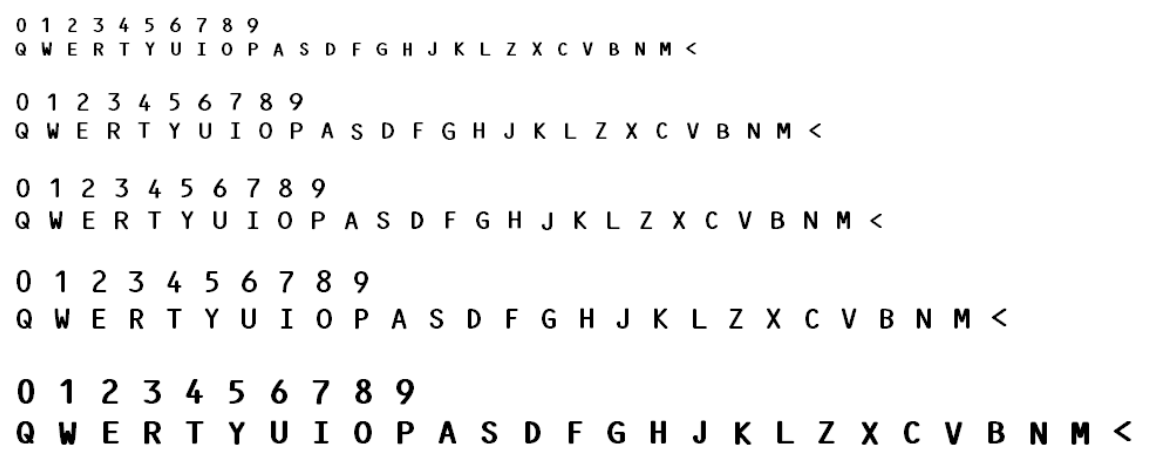 |
| 2 | Funkcja nakłada niezbędne filtry na plik z danymi:gray = cv2.cvtColor(im, cv2.COLOR_BGR2GRAY) blur = cv2.GaussianBlur(gray, (5, 5), 0) thresh = cv2.adaptiveThreshold(blur, 255, 1, 1, 11, 2)
W wyniku czego uzyskujemy: |
| 3 | Następnie funkcja wyszukuje znaki, wycina oraz skaluje do rozmiaru 20×20:image, contours, _ = cv2.findContours(thresh, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE) for cnt in contours: if cv2.contourArea(cnt) > 20: [x, y, w, h] = cv2.boundingRect(cnt) if h > 10: im = copy.copy(im_copy) cv2.rectangle(im, (x, y), (x + w, y + h), (0, 0, 255), 2) roi = thresh[y:y + h, x:x + w] roismall = cv2.resize(roi, (20, 20))
W wyniku czego otrzymujemy obraz znaku 20×20: |
| 4 | Następnie Użytkownik jest proszony o wpisanie na klawiaturze jaki to znak. Po tej operacji obraz oraz numer znaku jest zapisywany w tablicy pamięci programu. |
| 5 | Po klasyfikacji wszystkich znaków tablice danych są zapisane na dysku np.savetxt('generalsamples.data', samples) np.savetxt('generalresponses.data', responses) |